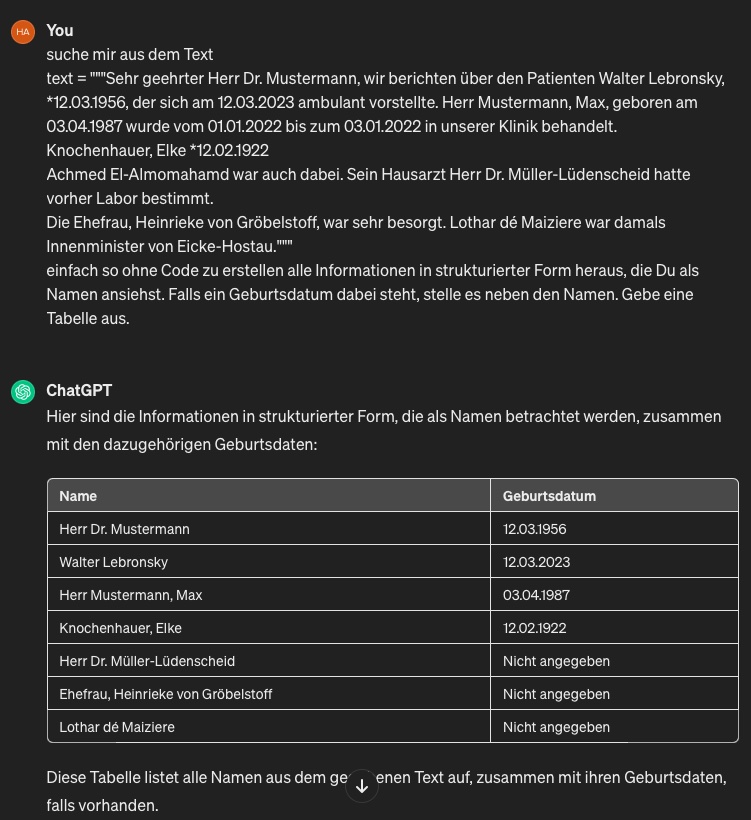
Am Wochenende habe ich (angefixt von den oben gezeigten, schon mal sehr vielversprechenden Ergebnissen) mit diversen Python-Tools wie Textblob, SpaCy etc. herumgespielt, um ohne Datenschutzprobleme (und damit ohne ChatGPT) lokal die Texte auswerten zu können. Ein sehr weites Feld. Man kommt von Hölzken auf Stöksken, wenn man es exakt und verlässlich haben will... Da habe ich mir die Zähne dran ausgebissen, wenn es nicht nur für Spezialfälle, sondern allgemeingültig funktionieren soll. Gerade auch komplizierte Namen (Doppelnamen mit Bindestrich, Adelstitel wie Lothar de Maiziére oder Namen aus fernen Ländern) machen Probleme wie auch die Variation "Name, Vorname" vs. "Vorname, Name". In der gezeigten Variante des Programms wurde zuletzt der Vorname wieder nicht mehr erkannt, was zwischenzeitlich schon klappte. Ich wäre daher an dem "kleinen" und offenbar funktionierenden Programm vom Kollegen Marks für diese Thematik sehr interessiert.
Mit dem unten gezeigten (auch mit ChatGPT-Hilfe) gebastelten Programm klappt das Herausfischen von ICD-10-Codes dagegen schon sehr gut und zuverlässig. Es geht mittels simplem regex ohne ChatGPT lokal im Text sehr einfach, da diese Textfigur (Buchstabe-Zahl-Zahl-Punkt-Zahl-Zahl) sehr einzigartig ist.
import PyPDF2

import os

import re


# Name des Pfads zur PDF-Datei

pdf_path = "/Users/hansjoerg/Python/MustermannMax2.PDF"


def extract_text_from_pdf(pdf_path):

    try:

        # PDF-Datei öffnen

        with open(pdf_path, 'rb') as file:

            # PDF-Reader erstellen

            reader = PyPDF2.PdfReader(file)

            # Textvariable initialisieren

            text = ''

            # Durch alle Seiten des PDFs iterieren

            for page_num in range(len(reader.pages)):

                # Seite extrahieren

                page = reader.pages[page_num]

                # Text von der Seite extrahieren und zur Textvariable hinzufügen

                text += page.extract_text()

                print(text)

            return text

    except Exception as e:

        print(f"Fehler beim Öffnen oder Lesen des PDFs: {e}")

        return None


if __name__ == "__main__":


    # Text aus der PDF-Datei extrahieren

    extracted_text = extract_text_from_pdf(pdf_path)

    # Wenn der Text erfolgreich extrahiert wurde, anzeigen

    if extracted_text:

        print()

        print("Extrahierter Text:")

        print(extracted_text)


    name_pattern = r"(Frau|Herr|Herrn)\s*(\w+\s\w+)"

    birthdate_pattern = r"geb.\s*am\s*(\d{2}\.\d{2}\.\d{4})"

    diagnosis_pattern = r"\b[A-Z]\d{2}\.\d{1,2}\b"


    # Suchen nach Namen, Vornamen und Geburtsdatum

    if extracted_text:

        name_match = re.search(name_pattern, extracted_text)

        birthdate_match = re.search(birthdate_pattern, extracted_text)


        if name_match and birthdate_match:

            gender = name_match.group(1)

            name = name_match.group(2)

            birthdate = birthdate_match.group(1)

            if gender == "Herr" or gender == "Herrn":

                gender_output = "M"

            elif gender == "Frau":

                gender_output = "W"

            else:

                gender_output = "Unknown"

        print("Geschlecht:", gender_output)

        print("Name:", name)

        print("Geburtsdatum:", birthdate)


        # Suchen nach Diagnosecodes

        diagnosis_codes = re.findall(diagnosis_pattern, extracted_text)

        if diagnosis_codes:

            print("\nDiagnosecodes:")

            for code in diagnosis_codes:

                print(code)


    else:

        print("Fehler: Extrahierter Text ist None.")
Beispieltext Inhalt:


Sehr geehrte Frau Dr. Pustekuchen,


Max Mustermann, geb. am 02.05.1955, wohnhaft Am Hundekuchen 25 in 28007 Bremen, stellte sich am 08.04.2024 in meiner Praxis vor.


Diagnosen:

gemischtförmiges Asthma bronchiale, schwergradig, gut kontrolliert (J45.83)

Allergische Rhinitis durch Pollen (Gräser, Frühblüher, Ragweed) (J30.1)

Nahrungsmittelintoleranz (K90.4)

Ganzjährig bestehende allergische Rhinitis [Tierhaare, Hausstaubmilbe] (J30.3)

Hyposensibilisierung gegenüber Allergenen (SLIT Gräser ab 04/2023; Birke 10/2023) (Z51.6)

Adipositas Grad I [WHO] (E66.90)

Arterielle Hypertonie (I95.9)

Hypothyreose (E03.9)


Aktuelle Anamnese: Routinemäßige Wiedervorstellung. Respiratorisch konstant, seltener Giemen, verminderte Allergiebeschwerden. SLIT seit 11/23, Itulazax, guter Effekt. Das Asthma ist (bezogen auf die letzten 4 Wochen) gemäß NVL-Kriterien teilweise kontrolliert, gemäß Asthma-Kontroll-Test (ACT) mit 18 von max. 25 Punkten eher nicht kontrolliert.


_____________________________________________________________________________________


Analyse-Ergebnis:


Geschlecht: M

Name: n Mustermann

Geburtsdatum: 02.05.1955


Diagnosecodes:

J45.83

J30.1

K90.4

J30.3

Z51.6

E66.90

I95.9

E03.9
Auch ChatGPT selbst hat aber Schwierigkeiten, aus unstruktierten und nicht standisiertem Text Namen und Geburtsdaten zu extrahieren, wenn ich meinen, mit fiesen Namen gespickten Test-Text bei ChatGPT eingebe, gelingt die korrekte Zuordnung auch eher mäßig. Evtl. kann man das mit Prompt-Optimierung noch weiter verbessern, zeigt aber auch, dass ChatGPT auch eher nicht der Goldstandard für das Problem ist.