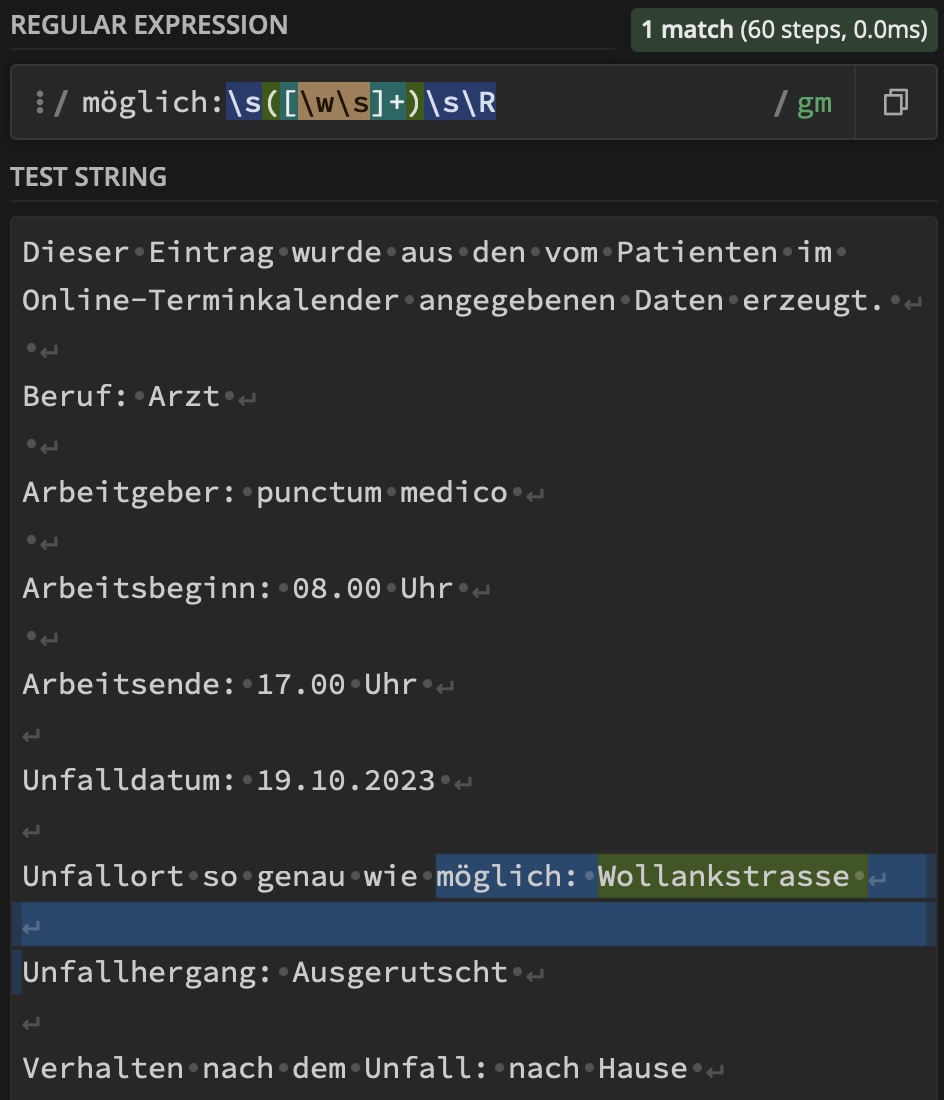
Wenn Sie in dem regex-Anteil, der die auszulesenden Zeichen beschreibt (in Ihrem Fall bisher: ([\w\W]) ) den Ausdruck \W weglassen und durch ein \s ersetzen (damit auch Spaces mit ausgelesen werden, es würde sonst nur das Wort bis zum ersten Space ausgegeben) klappt es. 🙂
Mit dem \W (= alles, was nicht Buchstabe/Zahl/Unterstrich ist) haben Sie in Ihrer Version dafür gesorgt, dass auch der Zeilenumbruch in den zu übernehmenden Text eingeschlossen wird.
\W Matches anything other than a letter, digit or underscore. Equivalent to [^a-zA-Z0-9_]