Moin,
das Problem können Sie relativ einfach lösen, indem Sie Ihren Idana-GDT-Rückschrieb geschickt strukturieren und dann per regex aus einem IDANA-GDT-Karteieintrag per Aktionskette die gewünschten Karteieinträge generieren. Diese Funktion spart mir immens viel Zeit. Ich nutze idana derzeit noch für die Anamnese (plane allerdings jetzt den Umzug zu den Patientenformularen von tomedo wegen der tieferen Integration). Es wird aus dem (recht umfangreichen) Anamnese-Formular von idana wird eine Karteieintrag "Idana-TXT" erstellt. Durch das Platzieren von Start- und Stop-Sequenzen fällt das Auslesen per regex dann sehr leicht. Also z.B. @@AktuelleAnamnese@@............Zeilenumbruch: 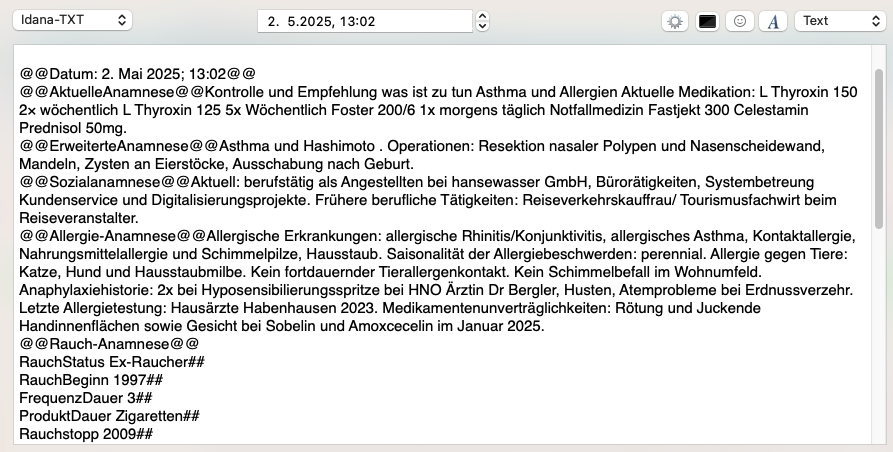
Da ich teils auch mehrere Idana-Bögen habe (z.B. Anamnese und ACT=Asthma Control Test) gibt es bei mir noch den Zwischenschritt, dass alle GDT-Rückschriebe in ein Extra-CKE "Kollektor" zusammengefügt werden, bevor die regex-Auswertung kommt. Diese findet in einem weiteren CKE "T-Idana" statt, wo dann das Aufteilen der aus Idana stammenden Inhalte in beliebige Einheiten erfolgt unter Verwendung der oben genannten Trennsequenzen wie @@AktuelleAnamnese
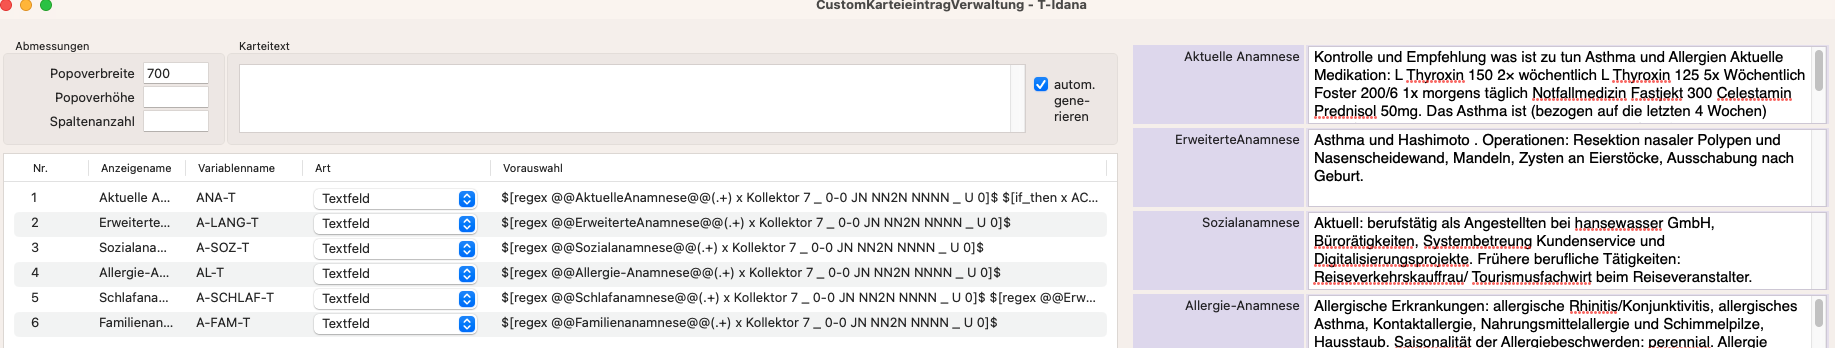
Wenn ich einen Neupatienten neu sehe, werden per Aktionskette alle Anamnese-Einträge mit der passenden Vorbefüllung aus dem T-Idana-CKE heraus angelegt. Als Beispiel hier die Sozialanamnese A-SOZ:
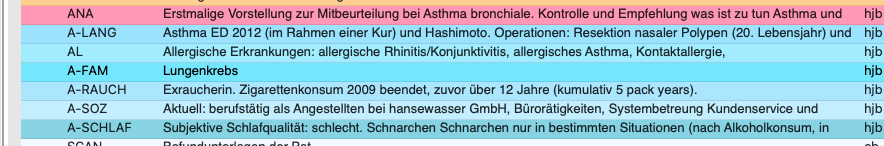
 Am Ende sieht es dann so aus: